三维数字展馆创意策划:如何让文化、符号会说话?
有一个我们复盘时反复碰到的现象:不少三维数字展馆把文化符号做得“很全”,纹样铺满墙、器物摆满架,用户逛完却记不住任何一个。
问题不在符号本身,而在符号被当成了“贴图”而不是“语言”。
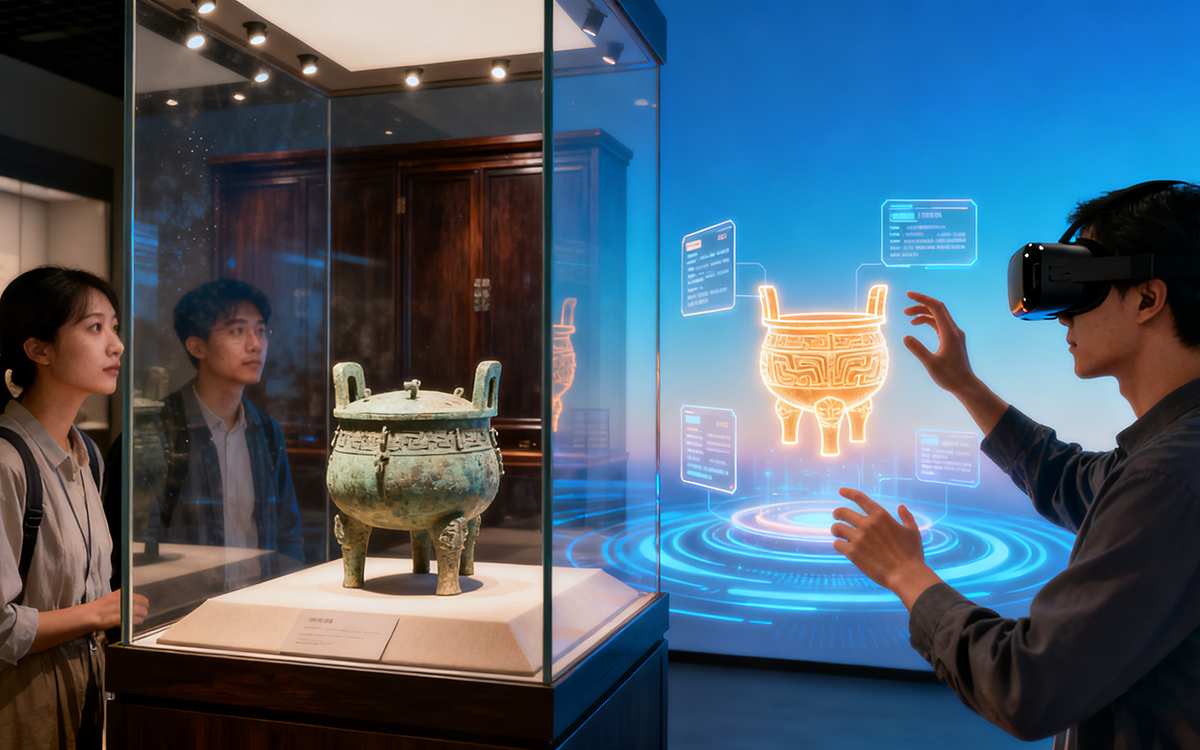
三维数字展馆的创意策划,真正的难点不是把文化元素搬进三维空间,而是让符号在空间里获得“说话的语法”——它和谁相邻、什么时候出现、用户触发它之后得到什么回应。
文化符号会说话,靠的不是数量,是一套可被用户读懂的叙事规则。
下面,由专业从事三维数字展馆设计与制作多年的【VR云展科技平台】为大家介绍一下:
一、先拆符号搬运的三堵墙
动手策划之前,得先看清多数项目的符号处理卡在哪。
实体展馆留下的惯性,比想象中顽固。
1、符号展示墙让纹样变成标本
实体展馆把纹样印在展板上,旁边配一段说明文字,观众读完即走。
三维数字展馆如果照搬这套逻辑,文化符号就只是一张会旋转的图片,用户没有任何理由在它面前停下来。
我们在一个非遗数字展馆项目里见过类似情况:入口展墙铺了十二种地方纹样,后台热力图显示,多数用户的视线在每个纹样上停留不到一秒。
符号被“展示”了,但没有被“阅读”。
2、解释权墙让用户停在接收端
传统策展是“策展人→说明牌→观众”的单向广播。
三维数字展馆的符号叙事应当把这个结构翻过来:用户先看到符号本身,解释层作为可展开的第二层等他主动触发。
太原美术馆在“跟着名画游山西”线上展里做了一件事:每期内容搭配“高清画作+真实照片+艺术家创作手记”,观众看到的不是标准说明牌,而是画家自己写下的感受。
叙事的方向从“被告知”变成了“被发现”,符号才获得了被主动接近的可能。
3、时间墙让符号止于展期
特展结束,符号随之封存。
三维数字展馆拆掉时间墙的方式,是把符号从“一次性陈列”变成“可反复调用的叙事节点”。
太原美术馆的线上展在实体展结束后热度不降反升,二十六期内容按主题逐期推送,持续吸引留言和转发,形成了明显的文化长尾效应。
符号的生命周期,不应该被物理展期框死。
二、符号转译先定三层语法
拆完墙,接下来要回答一个更具体的问题:一个平面纹样或一件器物,凭什么在三维空间里“开口说话”?
答案在转译的层级里。
1、视觉层给形与色
三维数字展馆的符号转译首先完成“形”与“色”的空间化:纹样不再是一条边饰,而可以成为空间的分隔界面、地面的导引路径、光线的投射图案。
仰韶地层密码馆的做法提供了一个参照:展馆以黄土地层为核心载体,以“读地层、识彩陶、探先民、溯文明”为主线,把地层剖面本身变成叙事的“画卷”。
符号的视觉转译不是复制纹样,是让纹样的结构关系在空间里找到对等物。
2、叙事层给角色与动作
视觉层解决“看起来像”,叙事层解决“它在故事里干什么”。
文化符号在三维数字展馆里应当被赋予角色和动作,而不是停留在装饰位置。
学术研究在讨论非遗数字博物馆时提出了“数字场域—叙事模型—感知系统”的框架,推动纹样从静态物象向活态展陈转化。
翻译成项目语言:纹样在哪个节点出现、它提示用户做什么动作、动作完成后解锁什么信息,这三件事需要在策划阶段就写清楚,而不是留给建模师“看着办”。
3、交互层给触发与反馈
符号“会说话”的最后一层,是用户能触发它、它给用户回应。
三维数字展馆的符号交互应当遵循“轻触发、快反馈、可积累”的原则:用户不需要学习复杂操作,一个靠近或轻触就能激活符号的叙事层,反馈在1秒内出现,多次交互后符号展示出更深的信息层级。
良渚“神纹之约”项目在策划阶段确立了“现代考古学者穿越对话良渚古国”的核心叙事逻辑,脚本历经十余轮评审,才把神人兽面纹从装饰元素转化为推动剧情的角色。
交互不是给符号加按钮,是给符号加“说话的理由”。
三、空间叙事替代线性陈列
符号转译的语法定好之后,下一个问题是它们在空间里怎么排。
实体展馆习惯用“起源—发展—高峰—影响”的时间轴把符号串起来,三维数字展馆不必受这条线的约束。
1、按追问逻辑组织符号
三维数字展馆的符号组织应当从“时间顺序”转向“追问顺序”:用户关心什么,符号就按什么顺序出现。
我们在一个地方文化云展项目里,把纹样从“按年代排列”改成“按三个追问排列”——这个符号在回应什么生活需求、它用什么材料和技术回应、这个回应在今天还剩多少有效性。
同样的符号库,用户的平均停留和二次点击都出现了可见变化。
追问逻辑的好处是,用户不需要先成为历史专家才能读懂符号。
2、符号之间留出呼吸距离
实体展馆怕空墙,三维数字展馆怕的是符号密度过高。
符号与符号之间应当留出足够的空间间隔和叙事间隔,让用户完成一次“读—理解—反应”的完整循环,再进入下一个符号。
仰韶地层密码馆把展馆分成序厅、考古探索、陶纹解读、先民生活、文明升华五个展区,每个展区聚焦一类符号关系,而不是把所有纹样堆在一个大厅里。
密度控制是符号“说话”的前提——太挤,谁都听不清。
3、用动线暗示符号关系
三维数字展馆的地面引导线和空间收放,应当承担暗示符号之间关系的作用,而不是只负责指路。
两条符号线索可以在主通道分岔处分开,在某个展项前重新汇合,用户沿着动线走完,符号之间的呼应关系已经在身体经验里建立了。
做了什么→怎么做的→效果如何:一个文博线上展厅项目把陶纹和青铜纹样的两条线索做成平行动线,在“材料变迁”展项前交汇,交汇点的停留时长和互动次数明显高于其他节点,符号关系从“文字说明”变成了“走出来的经验”。
四、交互节奏匹配符号密度
符号在空间里铺开之后,用户的认知负荷需要被管理。
三维数字展馆的交互设计,本质上是符号信息的释放节奏。
1、首屏只放一个符号锚点
三维数字展馆的入口区域只保留一个文化符号作为视线锚点,其他符号退到中景和背景。
多符号同时争抢注意力,结果是每个符号的首次注视时长都撑不过一秒。
一个判断标准很简单:遮住主符号,入口画面如果只剩空旷结构,说明锚点没有完成“引导进入”的功能。
如果入口同时放了纹样墙、器物模型、文字介绍和导览地图,用户的视线会在它们之间来回跳,哪个都记不住。
2、符号深度随交互次数解锁
文化符号的信息层级应当与用户的交互次数挂钩:第一次遇到给“形”和一句核心提示,第二次给背景,第三次给关联符号的对照。
在预算和工期允许的情况下,建议把符号的叙事层做成可累积的展开结构,而不是一次性全部弹出。
工期紧的话,至少让符号在用户第二次经过时呈现与第一次不同的信息,制造“这里还有东西”的预期。
3、音频与动效做符号的语气
符号“说话”的“语气”,由动效速度和音频质感决定。
旋转太快,符号显得焦躁。
完全静止,符号显得死板。
我们在多个项目中观察到的平衡区间是:符号的循环动效周期控制在8到12秒,音频以环境层为主、提示音为辅,避免每个符号都配一段旁白。
旁白太多,符号就从“说话”变成了“念稿”。
五、我曾踩过的坑:符号做得很美,但没有语法
2025年一个地方非遗数字展馆项目,客户提供了一批精美的纹样矢量文件,团队花了大量时间把纹样做成三维浮雕、动态贴图和粒子特效,单个符号的视觉完成度很高。
上线后数据却很平:用户在各展项之间的移动路径杂乱,符号的二次点击率很低,留言里出现最多的一句是“好看,但不知道看什么”。
1、问题出在符号之间没有关系
复盘时发现,每个符号都被做成了“独立展项”,彼此之间没有叙事上的先后和呼应。
用户面对一排同样精美、同样重要的符号,失去了判断“先看哪个、为什么看”的依据。
符号的美学质量再高,如果它们之间没有语法,用户在认知上就无法把碎片拼成意义。
2、后来改了什么
第二个类似项目里,我们把符号从“平铺展示”改成“一条主线索加两条支线”:主线索用三个递进的追问串联核心符号,支线符号在用户主动探索时出现,且每个支线符号都与主线索的某个节点有明确关联。
同样的纹样库,用户的路径集中度、符号二次点击率和平均停留都出现了可观测的提升。
教训后来变成了内部的一条检查项:如果一个三维数字展馆的符号策划案里,每个符号都能独立成立、互不依赖,那它大概率还没有形成“会说话”的语法。
六、评估看符号是否被读懂
符号“会说话”的效果,不能用“总访问量”或“平均停留时长”来交差。
三维数字展馆的符号叙事评估,应当盯住“符号被主动触发率”“符号叙事层的完成深度”和“符号之间的路径关联度”三个指标。
1、主动触发率比曝光量重要
做了什么事→怎么做的→效果如何:在一个文化云展项目中,我们把符号的“被动展示”和“主动触发”分开统计。
被动展示的曝光量很高,但主动触发率只有个位数。
调整符号的入口锚点和触发提示之后,主动触发率出现了可见上升,而总曝光量并没有明显变化。
这说明曝光量掩盖了“符号有没有被真正接近”的问题。
2、叙事完成深度反映符号是否被读懂
符号的信息层如果被用户逐层展开,说明符号在“说话”。
如果多数用户停在第一层就走,说明符号只是“被看到”。
把“符号叙事层展开到第二层及以上的用户占比”作为独立指标跟踪,比看总点击量更有诊断价值。
《国家信息化发展报告(2025年)》的数据显示,截至2025年底,全国7188家博物馆推出4.6万余个线上展览,网站访问量超过55.2亿人次。
盘子足够大,符号叙事如果只停留在“有展览可看”的层面,用户的选择成本很低,转身就走几乎没有代价。
3、路径关联度检验语法是否成立
用户在符号之间的移动路径如果呈现出可识别的聚集和串联,说明符号之间的叙事关系被感知到了。
如果路径随机散乱,说明符号在用户认知里仍然是孤立的。
这个指标不需要复杂的埋点,把展项之间的跳转关系做成一张流向图,就能看出符号有没有形成“语法”。
从我们服务过的项目来看,路径集中度高的展馆,用户对“这个展馆讲了什么”的留言描述也明显更具体。
七、避坑指南与适用边界
1、三个高频执行误区
坑一:把符号数量当成文化厚度。
纹样铺得越满,单个符号的认知权重越薄。
符号的“说话”能力取决于它被组织的方式,不取决于它出现的次数。
坑二:符号转译只做视觉不做叙事。
三维浮雕和动态贴图是视觉层的完成,不是叙事层的完成。
符号在故事里承担什么角色、触发什么动作,需要在建模之前就写进策划案。
坑三:所有符号用同一种交互语气。
核心符号和背景符号的交互深度应当有差别。
每个符号都配旁白、都弹详情,用户会被信息淹没,符号之间的轻重关系也消失了。
2、适用场景的边界
这套以“符号语法”为核心的策划方法,最适用于文化符号体系复杂、符号之间存在可讲述关系、且展期前后有持续运营窗口的三维数字展馆,尤其是非遗馆、地方文化馆、考古遗址类展馆。
如果是一场符号数量少、每件都需要独立细看的精品文物展,符号之间的叙事串联可以适度弱化,把资源集中在单件器物的材质、光照和微观细节上。
反过来,如果展馆的文化符号主要是装饰性元素、不承担叙事功能,强行给它们编织“语法”反而显得过度设计,把视觉节奏和空间氛围做好更务实。
结语:符号语法与叙事权重
三维数字展馆让文化符号“会说话”的核心做法是:先拆掉符号展示墙、解释权墙和时间墙,按“视觉—叙事—交互”三层语法完成符号的空间转译,用追问逻辑而非时间轴组织符号关系,以符号密度控制交互节奏,让符号信息随用户交互次数逐层解锁,再用主动触发率、叙事完成深度和路径关联度替代曝光量做效果评估。
这套方法把符号从“装饰素材”转化为“叙事语言”,代价是策划阶段需要投入更多精力做符号关系图谱和叙事脚本,而不是把符号直接交给建模环节。
当AI能够根据用户的停留和触发行为,实时调整符号的出现顺序和叙事深度,三维数字展馆的符号语法会不会从“策划阶段写死的脚本”变成“运行时生成的对话”?到那时候,文化符号的“本真性”靠什么来守——是一套更严格的符号语义约束,还是更聪明的生成边界?这个问题,可能比符号转译的技术选型更值得在项目立项时先想清楚。